8 Symulacja procesu
Po spotkaniu: dopiszesz do modelu tok czasy, zasoby i prawdopodobieństwa · uruchomisz symulację i odczytasz wskaźniki: czas cyklu, oczekiwanie, wykorzystanie zasobów · porównasz dwa scenariusze organizacji pracy i przeanalizujesz wyniki w R · Czas: Nauka 40 min, Wyzwanie 50 min
8.1 Nauka
Po co symulować proces
Model procesu pokazuje, co się dzieje i kto to robi. Nie mówi jednak, ile to trwa, gdy spraw jest dużo, a ludzi mało. Kierownik archiwum zna takie pytania z codziennej pracy:
- Ile czasu czeka wnioskodawca na odpowiedź na kwerendę, gdy wniosków jest dwa razy więcej niż zwykle?
- Czy trzeci archiwista skróci czas obsługi, czy będzie siedział bezczynnie?
- Co da przeniesienie decyzji o odmowie na początek procesu?
Odpowiedź „sprawdźmy w praktyce” bywa kosztowna. Zatrudnienie pracownika albo zmiana regulaminu to decyzje na miesiące. Symulacja pozwala sprawdzić je wcześniej, na modelu. Program przeprowadza przez proces kilkaset fikcyjnych spraw. Losuje czasy pracy i decyzje, pilnuje, żeby jeden pracownik robił jedną rzecz naraz, i liczy, ile każda sprawa czekała.
Symulacja nie przewiduje przyszłości. Pokazuje skutki założeń. Jeśli założysz, że poszukiwanie w zasobie trwa średnio 6 godzin, a w rzeczywistości trwa 10, wynik będzie błędny. Dlatego każdą symulację opisujesz razem z jej założeniami.
Warstwa symulacji w tok
Parametry symulacji zapisujesz w tym samym pliku co model. Nie zmieniają one eksportu BPMN: diagram w Camunda Modeler wygląda tak samo z nimi i bez nich. Dochodzą trzy instrukcje i pięć atrybutów:
| Zapis | Znaczenie |
|---|---|
simulate cases=300 seed=7 arrival="exp(4h)" |
ile spraw przeprowadzić, ziarno losowania, odstęp między kolejnymi sprawami |
resource archiwisci "Archiwiści" count=2 |
zasób: grupa wymiennych pracowników i ich liczba |
variable pilna "bern(0.2)" |
zmienna sprawy losowana raz, na początku sprawy |
czynność by=archiwisci |
czynność czeka na wolnego pracownika z tego zasobu |
czynność duration="lnorm(6h, 3h)" |
czas wykonania czynności |
czynność assign="kompletny=bern(0.9)" |
zmienne ustawiane po zakończeniu czynności, np. decyzja człowieka |
zdarzenie delay="exp(3d)" |
czas oczekiwania na wiadomość, np. na uzupełnienie wniosku |
przepływ p=0.85 |
prawdopodobieństwo wyboru gałęzi po bramce bez warunków |
Fragment modelu, w którym archiwista ocenia kompletność wniosku, a wnioskodawca czasem musi go uzupełnić:
    user ocena "Ocena wniosku" by=archiwisci duration="lnorm(30m, 10m)" assign="kompletny=bern(0.9)"
    xor czy "Czy wniosek kompletny?"
    send prosba "Prośba o uzupełnienie" duration="5m"
    catch uzupelnienie "Uzupełnienie wpłynęło" message="Uzupełnienie" delay="exp(3d)"

flow czy -> poszukiwania "tak" when="kompletny = true"
flow czy -> prosba "nie" default
flow prosba -> uzupelnienie -> ocena
Po ocenie zmienna kompletny jest prawdziwa w 90% spraw. Bramka sprawdza ją tak samo jak w procesie wykonywalnym (rozdział 7). Pozostałe sprawy wracają do oceny po uzupełnieniu, które przychodzi średnio po trzech dniach.
Bramka może więc wybierać gałąź na dwa sposoby. Jeśli przepływy mają warunki when, symulator liczy je na danych sprawy. Jeśli mają p=, losuje gałąź. Prawdopodobieństwa przepływów z jednej bramki muszą sumować się do 1. Inaczej tok check zgłosi ostrzeżenie S002.
Rozkłady: jak opisać „to zależy”
Czas pracy nigdy nie jest stały. Poszukiwanie w zasobie trwa czasem godzinę, a czasem dwa dni. Dlatego czasy zapisujesz jako rozkłady, czyli opisy tego, jak często zdarzają się krótkie i długie przypadki. Jednostki czasu to s, m (minuty), h i d.
| Rozkład | Kiedy go użyć | Przykład |
|---|---|---|
fixed(15m) albo 15m |
czynność trwa zawsze tyle samo | wydruk zaświadczenia |
tri(min, najczęściej, max) |
nie masz danych, ale pracownik umie podać najkrótszy, typowy i najdłuższy czas | rejestracja wniosku: tri(5m, 10m, 20m) |
lnorm(średnia, odchylenie) |
masz dane z rejestru (średnią i odchylenie standardowe); większość spraw jest krótka, ale zdarzają się bardzo długie | poszukiwania: lnorm(6h, 3h) |
exp(średnia) |
odstępy między niezależnie napływającymi sprawami | wpływ wniosków: exp(4h) |
unif(a, b) |
każda wartość z przedziału jest równie prawdopodobna | |
bern(p) |
zdarzenie zachodzi albo nie, z prawdopodobieństwem p |
wniosek kompletny: bern(0.9) |
cat(a=p, b=q) |
jedna z kilku kategorii | cat(genealogiczna=0.6, majątkowa=0.4) |
Najczęściej zaczyna się od rozkładu trójkątnego (tri). Wystarczy zapytać trzy osoby z działu: „ile najkrócej, ile zwykle, ile najdłużej?”. Gdy instytucja ma dane z systemu (np. daty rejestracji i wysłania odpowiedzi w EZD), lepszy jest lnorm ze średnią i odchyleniem policzonymi z tych danych.
Ziarno i powtarzalność
Symulator losuje, ale robi to w sposób odtwarzalny. Ziarno (seed=) ustala ciąg losowań. Ten sam model z tym samym ziarnem daje zawsze ten sam wynik, co do sekundy. Dzięki temu wynik w raporcie da się sprawdzić, a różnicę między dwoma scenariuszami da się przypisać zmianie w modelu, a nie przypadkowi.
Ziarno nie gwarantuje jednak, że w dwóch scenariuszach wylosują się identyczne sprawy. Gdy zmienisz liczbę pracowników, czynności kończą się w innej kolejności, więc kolejne losowania przypadają innym sprawom. Dlatego porównujesz wskaźniki z kilkuset spraw, a nie losy pojedynczych spraw.
Przykład: kwerenda archiwalna
Archiwum państwowe przyjmuje wnioski o kwerendę genealogiczną. Kancelista rejestruje wniosek, archiwista ocenia, czy kwerenda jest możliwa (w 15% spraw nie jest), a potem szuka w zasobie i opracowuje odpowiedź. Wnioski wpływają średnio co 4 godziny. Pracuje dwóch archiwistów i jeden kancelista.
tok 0.1 "Kwerenda archiwalna: symulacja obciążenia"

pool archiwum "Archiwum Państwowe"
  lane kancelaria "Kancelaria"
    start wplyw "Wniosek o kwerendę wpłynął"
    user rejestracja "Rejestracja wniosku" by=kancelisci duration="tri(5m, 10m, 20m)"
    send odmowa "Wysłanie odmowy" by=kancelisci duration="tri(5m, 10m, 15m)"
    end odrzucony "Wniosek odrzucony"
    send odpowiedz "Wysłanie odpowiedzi" by=kancelisci duration="tri(5m, 10m, 15m)"
    end zakonczona "Kwerenda zakończona"
  lane archiwista "Archiwista"
    user ocena "Ocena wniosku" by=archiwisci duration="lnorm(30m, 10m)"
    xor mozliwa "Czy kwerenda jest możliwa?"
    user poszukiwania "Poszukiwania w zasobie" by=archiwisci duration="lnorm(6h, 3h)"
    user opracowanie "Opracowanie odpowiedzi" by=archiwisci duration="tri(30m, 1h, 2h)"

flow wplyw -> rejestracja -> ocena -> mozliwa
flow mozliwa -> poszukiwania "tak" p=0.85
flow mozliwa -> odmowa "nie" p=0.15
flow odmowa -> odrzucony
flow poszukiwania -> opracowanie -> odpowiedz -> zakonczona

simulate cases=300 seed=7 arrival="exp(4h)"
resource archiwisci "Archiwiści" count=2
resource kancelisci "Kanceliści" count=1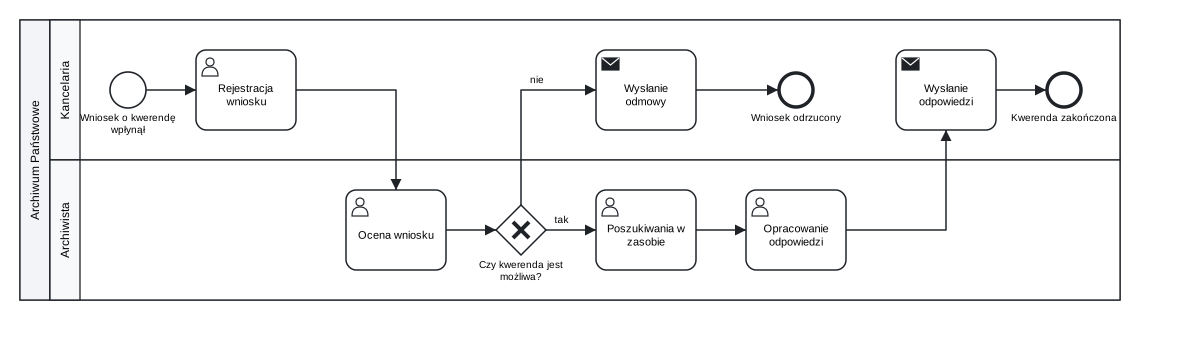
Rysunek 8.1: Kwerenda archiwalna: model z parametrami symulacji. Diagram wygląda tak samo jak bez nich.
Pobierz model (.tok) Pobierz eksport BPMN (.bpmn)
Symulację uruchamia polecenie:
tok sim 08-kwerenda.tok --lang plSymulacja (ziarno 7): rozpoczęte sprawy 300, zakończone 300
Zakończenia
zakonczona 252 84.0%
odrzucony 48 16.0%
Czas cyklu: średnio 17.5 h, mediana 14.3 h, 90. percentyl 1.5 d
Czynności (liczba, średnie oczekiwanie, średnie wykonanie)
Rejestracja wniosku 300 26 s 11.6 min
Ocena wniosku 300 4.2 h 30.8 min
Poszukiwania w zasobie 252 4.0 h 5.8 h
Opracowanie odpowiedzi 252 3.8 h 1.1 h
Wysłanie odpowiedzi 252 30 s 10.1 min
Wysłanie odmowy 48 26 s 10.3 min
Zasoby (wykorzystanie)
Archiwiści x2 80.9%
Kanceliści x1 9.2%Jak czytać raport
| Wskaźnik | Co znaczy | W przykładzie |
|---|---|---|
| zakończenia | ile spraw skończyło się którym zdarzeniem końcowym | 84% odpowiedzi, 16% odmów (założono 15%; różnica to wynik losowania) |
| czas cyklu | czas od wpływu wniosku do zakończenia sprawy | średnio 17,5 h |
| mediana | połowa spraw trwała krócej, połowa dłużej | 14,3 h |
| 90. percentyl | 9 na 10 spraw zakończyło się w tym czasie | 1,5 dnia |
| średnie oczekiwanie | ile sprawa czekała na wolnego pracownika przed czynnością | przed każdą czynnością archiwisty około 4 godzin |
| średnie wykonanie | ile trwała sama praca | poszukiwania 5,8 h |
| wykorzystanie | jaką część czasu pracownicy danego zasobu byli zajęci | archiwiści 81%, kancelista 9% |
Najważniejszy wniosek kryje się w kolumnie oczekiwania. Przed każdą z trzech czynności archiwisty sprawa czeka około 4 godzin. Razem to około 12 godzin, czyli dwie trzecie średniego czasu cyklu. Sama praca trwa krócej niż czekanie na nią. Archiwiści są zajęci przez 81% czasu. Przy takim obciążeniu każde nagromadzenie wniosków tworzy kolejkę, która długo się rozładowuje. Wąskim gardłem (bottleneck) procesu są archiwiści, a nie kancelaria.
Wynik da się sprawdzić prostym rachunkiem. Jeden wniosek wymaga średnio 0,5 h oceny oraz, w 85% spraw, około 6 h poszukiwań i 1,2 h opracowania. To razem około 6,6 h pracy archiwisty. Wnioski przychodzą co 4 godziny, a archiwistów jest dwóch, więc obciążenie wynosi około 6,6 / (2 × 4) ≈ 82%. Symulacja to potwierdza. Rachunek nie mówi jednak, jak długie będą kolejki. To pokazuje dopiero symulacja.
Porównanie scenariuszy
Czy trzeci archiwista skróci czas obsługi? Wystarczy zmienić jeden wiersz modelu (count=3), zapisać kopię jako 08-kwerenda-3.tok i uruchomić symulację ponownie:
Symulacja (ziarno 7): rozpoczęte sprawy 300, zakończone 300

Zakończenia
  zakonczona                        257   85.7%
  odrzucony                          43   14.3%

Czas cyklu: średnio 7.6 h, mediana 7.1 h, 90. percentyl 13.4 h

Czynności  (liczba, średnie oczekiwanie, średnie wykonanie)
  Rejestracja wniosku               300        30 s    11.8 min
  Ocena wniosku                     300    23.3 min    30.2 min
  Wysłanie odmowy                    43        38 s    10.3 min
  Poszukiwania w zasobie            257    18.6 min       5.6 h
  Opracowanie odpowiedzi            257    21.6 min       1.2 h
  Wysłanie odpowiedzi               257        40 s     9.8 min

Zasoby (wykorzystanie)
  Archiwiści                     x3    54.2%
  Kanceliści                     x1     9.3%
Pobierz scenariusz z trzema archiwistami (.tok)
| Wskaźnik | 2 archiwistów | 3 archiwistów |
|---|---|---|
| średni czas cyklu | 17,5 h | 7,6 h |
| 90. percentyl | 1,5 d | 13,4 h |
| oczekiwanie przed oceną | 4,2 h | 23 min |
| wykorzystanie archiwistów | 81% | 54% |
Trzeci archiwista skraca średni czas cyklu ponad dwukrotnie, choć sama praca trwa tyle samo. Znika prawie całe czekanie. Ceną jest niższe wykorzystanie: archiwiści są zajęci przez nieco ponad połowę czasu. To nie jest „marnowanie” pracowników. Wolny czas pozwala obsłużyć nagły napływ wniosków i wykonywać zadania spoza modelu, np. opracowywanie zespołów. Decyzję podejmuje kierownik. Symulacja daje mu liczby, a nie odpowiedź.
Zwróć uwagę, że liczba odmów różni się między scenariuszami (48 i 43), choć model odmów się nie zmienił. To skutek opisany wyżej: przy innej kolejności zdarzeń losowania przypadają innym sprawom. Różnice rzędu kilku procent w udziałach zakończeń są w symulacji naturalne.
Dziennik zdarzeń i dane spraw
Raport podaje średnie. Dokładniejszą analizę umożliwiają dwa pliki CSV, które symulator zapisuje na życzenie:
tok sim 08-kwerenda.tok --log 08-kwerenda-log.csv --cases-csv 08-kwerenda-sprawy.csvDziennik zdarzeń (--log) ma jeden wiersz na każde wykonanie czynności:
| Kolumna | Zawartość |
|---|---|
case |
numer sprawy |
activity, label |
identyfikator i etykieta czynności |
resource |
zasób z by= |
enqueue |
kiedy sprawa dotarła do czynności |
start |
kiedy pracownik zaczął pracę |
end |
kiedy czynność się zakończyła |
status |
completed (zakończona) albo interrupted (przerwana przez zdarzenie graniczne) |
Dane spraw (--cases-csv) mają jeden wiersz na sprawę: case, start, end, end_event (zdarzenie końcowe), cycle_time_s (czas cyklu w sekundach) i variables (zmienne sprawy).
Dziennik ma taki sam układ jak dzienniki zdarzeń z systemów informatycznych. Te same metody analizy działają więc na danych z symulacji i na danych rzeczywistych, np. z EZD albo systemu bibliotecznego.
Analiza wyników w R
Poniższy skrypt w podstawowym R, bez dodatkowych pakietów, wczytuje wyniki obu scenariuszy. Liczy średnią, medianę i 90. percentyl czasu cyklu, zlicza zakończenia, liczy średnie oczekiwanie przed czynnościami archiwistów i rysuje wykres pudełkowy.
wczytaj_sprawy <- function(plik, scenariusz) {
  d <- read.csv(plik, encoding = "UTF-8")
  d$scenariusz <- scenariusz
  d$czas_h <- d$cycle_time_s / 3600
  d
}
sprawy <- rbind(
  wczytaj_sprawy("08-kwerenda-sprawy.csv", "2 archiwistów"),
  wczytaj_sprawy("08-kwerenda-3-sprawy.csv", "3 archiwistów")
)
aggregate(czas_h ~ scenariusz, data = sprawy, FUN = function(x)
  round(c(srednia = mean(x), mediana = median(x), p90 = unname(quantile(x, 0.9))), 1))
table(sprawy$scenariusz, sprawy$end_event)
boxplot(czas_h ~ scenariusz, data = sprawy, horizontal = TRUE, las = 1,
        xlab = "Czas cyklu (godziny)", ylab = "")
Wynik pierwszej części skryptu:
     scenariusz czas_h.srednia czas_h.mediana czas_h.p90
1 2 archiwistów           17.5           14.3       36.9
2 3 archiwistów            7.6            7.1       13.4
odrzucony zakonczona
2 archiwistów 48 252
3 archiwistów 43 257Pełny skrypt, z oczekiwaniem przed czynnościami policzonym z dziennika zdarzeń:
Wykres pudełkowy pokazuje to, czego nie widać w średnich. Przy dwóch archiwistach rozrzut czasów jest bardzo duży: co dziesiąta sprawa kończy się w niecałe 5 godzin, a najdłuższe trwają prawie trzy dni. Dla wnioskodawcy ważny jest nie tylko średni czas, ale też to, jak bardzo jest on przewidywalny. Dlatego w raportach podaje się percentyle, nie tylko średnią.
Granice symulacji w tok 0.1
- Brak kalendarzy pracy. Czas płynie bez przerw: zadanie rozpoczęte o 16:00 i trwające 6 godzin kończy się o 22:00. Wyniki odpowiadają pracy ciągłej. Aby przeliczyć je na dni robocze, podziel czas przez długość dnia pracy, pamiętając, że to tylko przybliżenie.
- Jeden proces. Symulowany jest proces pierwszego basenu, który go ma. Przepływy komunikatów do innych basenów nie są symulowane. Odpowiedź z zewnątrz modelujesz zdarzeniem z
delay=. - Pracownicy wymienni. Zasób to grupa jednakowych pracowników. Różnice kompetencji modelujesz osobnymi zasobami.
- Znaczniki pętli i wielu instancji (
loop,parallel,sequential) są w tej wersji wykonywane jeden raz.
8.2 Wyzwanie
Polecenie: przygotuj dla kierownika archiwum krótką analizę trzech scenariuszy organizacji kwerend.
Dane wejściowe: model 08-kwerenda.tok z części Nauka i skrypt 08-analiza.R.
Scenariusze:
- Stan obecny: model bez zmian.
- Wzrost liczby wniosków: wnioski wpływają średnio co 3 godziny (
arrival="exp(3h)"), personel bez zmian. - Wcześniejsza odmowa: kancelista wstępnie sprawdza wniosek przy rejestracji i od razu odrzuca te, których nie da się zrealizować. Dodaj w linii kancelarii bramkę za rejestracją z gałęzią odmowy
p=0.15. Wnioski możliwe do realizacji przechodzą do archiwisty, a ocena archiwisty trwa wtedy krócej:tri(10m, 15m, 30m)i już niczego nie odrzuca. Rejestracja z oceną wstępną trwatri(10m, 20m, 30m).
Kroki:
- Zapisz każdy scenariusz jako osobny plik
.tok. Sprawdź go poleceniemtok check --lang pl. - Uruchom
tok simz tym samym ziarnem dla wszystkich scenariuszy, z zapisem--logi--cases-csv. - Dostosuj skrypt R do trzech scenariuszy i przygotuj tabelę: średni czas cyklu, 90. percentyl, wykorzystanie archiwistów i kancelisty.
- Napisz 5–8 zdań rekomendacji dla kierownika: który scenariusz jest najkorzystniejszy, jakie założenia przyjąłeś i co trzeba by sprawdzić w rzeczywistości, zanim wprowadzi się zmianę.
Rezultat: trzy pliki .tok, skrypt R i notatka z tabelą i rekomendacją. Zachowaj je jako wzór dla części symulacyjnej projektu (rozdział 10).
Praca: w parach.
Czas: 50 minut.
Na co zwrócić uwagę
- Porównuj scenariusze z tym samym ziarnem i tą samą liczbą spraw. Inaczej różnica może wynikać z losowania.
- Jeśli wykorzystanie zasobu zbliża się do 100%, kolejka rośnie przez cały czas symulacji, a wyniki zależą od liczby spraw. To znak, że proces nie nadąża za napływem wniosków. Taki wynik jest ważniejszy niż dokładna wartość czasu cyklu.
- W scenariuszu 3 przenosisz pracę z archiwistów do kancelarii. Sprawdź, czy kancelaria nie staje się nowym wąskim gardłem.
- Model z parametrami symulacji nadal musi przechodzić
tok checkbez błędów. OstrzeżenieS003oznacza bramkę bez warunków i bez prawdopodobieństw. Symulator wybiera wtedy zawsze pierwszy przepływ.
8.3 Pytania sprawdzające
- Na jakie pytania kierownika instytucji może odpowiedzieć symulacja, a na jakie nie?
- Kiedy użyjesz rozkładu
tri, a kiedylnorm? Skąd weźmiesz ich parametry? - Do czego służy ziarno losowania? Dlaczego w dwóch scenariuszach z tym samym ziarnem liczba odmów może się różnić?
- Co oznacza wykorzystanie zasobu na poziomie 81%? Jak wpływa na czas oczekiwania?
- Dlaczego w raporcie podaje się 90. percentyl czasu cyklu, a nie tylko średnią?
- Jakie ograniczenie symulacji w tok 0.1 sprawia, że wyniki odpowiadają pracy ciągłej, a nie dniom roboczym?